вторник, 22 августа 2017 г.

О recon-ng


recon-ng - это приложение для OSINT - Open Source INTellegence (разведки на основе открытых данных).

Кратко о recon-ng:
- осуществляет автоматизированный поиск юзернеймов, профилей, устройств, и т.д.;
- открытый исходный код;
- cli интерфейс а-ля matesploit;
- использует модули;
- написан на Python;

Установка

pip install -r REQUIREMENTS
./recon-ng

Начало работы

Для полноценной работы фреймворка нужно обеспечить ему доступ к API популярный онлайн-сервисов вроде google, linkedin, twшtter и д.р.
Но не все модули этого требуют.
Например, чтобы получить ключ для использования API google нужно зарегистрироваться и по следующей ссылке: https://console.developers.google.com/apis/dashboard 

Понадобится следующие API
  • YouTube Data API
  • Custom Search API

Полный список необходимых ключей и сервисов приведён на сайте разработчика, в разделе документации.

В программе список ключей хранится в таблице keys. 
show keys
  +------------------------------------------------------------+
  |       Name       |                  Value                  |
  +------------------------------------------------------------+
  | bing_api         |                                         |
  | builtwith_api    |                                         |
  | censysio_id      |                                         |
  | censysio_secret  |                                         |
  | flickr_api       |                                         |
  | fullcontact_api  |                                         |
  | github_api       |                                         |
  | google_api       |                                         |
  | google_cse       |                                         |
  | hashes_api       |                                         |
  | instagram_api    |                                         |
  | instagram_secret |                                         |
  | ipinfodb_api     |                                         |
  | jigsaw_api       |                                         |
  | jigsaw_password  |                                         |
  | jigsaw_username  |                                         |
  | linkedin_api     |                                         |
  | linkedin_secret  |                                         |
  | pwnedlist_api    |                                         |
  | pwnedlist_iv     |                                         |
  | pwnedlist_secret |                                         |
  | shodan_api       |                                         |
  | twitter_api      |                                         |
  | twitter_secret   |                                         |
  +------------------------------------------------------------+


Добавить ключ просто
 keys add google_api <ключ>

Источники информации
recon-ng использует множество источников информации. Это и популярные поисковые системы, социальные сети и популярные сервисы вроде github.
Среди них можно отметить специализированные поисковики:
см. таблицу выше, чтобы понять нужен ли ключ для обращения к API этих поисковиков.


Начало использования

Текстовый интерфейс похож на таковой Metasploit и set (Social Enginering Toolkit). Значит здесь можно создавать рабочие окружения (workspace), подключать модули, задавать их параметры и наконец запускать.  Информация будет сохранятся в БД. Для каждого рабочего окружения сохраняются свои экземпляры таблиц.
Создать рабочее место
workspace add <name>

Просмотреть основные параметры (прокси, юсерагент, и т.п.)
set

Name        Current Value  Required  Description
  ----------  -------------  --------  -----------
  NAMESERVER  8.8.8.8        yes       nameserver for DNS interrogation
  PROXY                      no        proxy server (address:port)
  THREADS     10             yes       number of threads (where applicable)
  TIMEOUT     10             yes       socket timeout (seconds)
  USER-AGENT  Recon-ng/v4    yes       user-agent string
  VERBOSITY   1              yes       verbosity level (0 = minimal, 1 = verbose, 2 = debug)


В начале хорошо бы установить правдоподобный User-Agent чтобы не банили поисковики.
Например
Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2228.0 Safari/537.36
Возможно понадобится использовать прокси чтобы обойти блокировки некоторых социальных сетей или сайтов в некоторых странах.

Показать все таблицы
show schema

Показать список модулей
show modules

Использовать модуль
use <module name>

После этой команды модуль будет готов к настройке и запуску.

Посмотреть описание и настройки загруженного в данный момент модуля
show info

Как правило для работы модуля нужно задать одну или несколько начальный переменных (адрес сайта, юзернейм, и.т.д). Их название и назначение зависит от назначения модуля. По умолчанию большинство модулей используют данные из таблиц. Почти у каждого модуля есть параметр SOURCE (см. пример ниже). SOURCE = default если будут использованы данные из таблицы. Но можно брать данные, например список адресов электронной почты из фала
set SOURCE полное_имя_файла
или если нужно проверить только одно значение, то  указать его непосредственно
set SOURCE значение
После выполнения какого-нибудь модуля результаты работы обычно записываются в таблицы. 

Показать число записей в каждой таблице (это тоже отдельная таблица)
 show dashboard

Показать любую таблицу, например profiles
show profiles
Добавить запись в таблицу
add имя_таблицы поле1~поле2~поле2...
Здесь нужно правильно учесть число полей.

Примеры использования


Проверка существования почтовых адресов
Загрузим модуль командой
use recon/contacts-contacts/mailtester
или просто указав имя модуля
use mailtetser
Просмотрим параметры
show info
      Name: MailTester Email Validator
      Path: modules/recon/contacts-contacts/mailtester.py
    Author: Tim Tomes (@LaNMaSteR53)

Description:
  Leverages MailTester.com to validate email addresses.

Options:
  Name    Current Value                        Required  Description
  ------  -------------                        --------  -----------
  REMOVE  False                                yes       remove invalid email addresses
  SOURCE  default                              yes       source of input (see 'show info' for details)

Source Options:
  default        SELECT DISTINCT email FROM contacts WHERE email IS NOT NULL
  <string>       string representing a single input
  <path>         path to a file containing a list of inputs
  query <sql>    database query returning one column of inputs
Здесь сказано, что если параметр SOURCE установлен в default, то для исходных данных будут выбраны все емейлы из таблицы contacts.
Значит нужно добавить запись в эту таблицу.

add contacts ~~~адрес_эл._почты~~~

Заполнять все поля в таблице contacts не обязательно. Поэтому разделяя поля тильдой просто оставим их пустыми, кроме поля электронной почты.
Сама таблица после добавления запись будет выглядеть так
show contacts

  +------------------------------------------------------------------------------------------------------------+
  | rowid | first_name | middle_name | last_name |       email       | title | region | country |    module    |
  +------------------------------------------------------------------------------------------------------------+
  | 3     |            |             |           | адрес_эл._почты |       |        |         | user_defined |
  +------------------------------------------------------------------------------------------------------------+


Если нужно проверить одну почту удобнее указать её адрес непостредственно параметру SOURCE
set SOURCE почта

Если адресов много, то можно и файл с ними указать
set SOURCE файл-с-емейлами

Наконец запустим модуль на выполнение:
run

Проверка почтового адреса делается запросом на сервер где он зарегистрирован. Судя по сообщениям программы не все серверы поддерживают реализованную проверку (возможно нужен ключ для API?), среди них:
gmail.com и hotmail.com.
На некоторых сервисах (rambler.ru) скрипт падает.

Поиск почты в haveibeenpwned.com
use recon/contacts-credentials/hibp_breachshow
set SOURCE ...
run
    
Если адреса не найдено, то вероятно аккаунты с этим почтовым адресом не были взломаны и хэши паролей не были опубликованы.

Поиск "интересных" файлов на сайте
     use discovery/info_disclosure/interesting_files
     [recon-ng][default][interesting_files] > set SOURCE mi-al.ru
     [recon-ng][default][interesting_files] > run

[*] http://mi-al.ru:80/robots.txt => 200. 'robots.txt' found!
[*] http://mi-al.ru:80/sitemap.xml => 301
[*] http://mi-al.ru:80/sitemap.xml.gz => 301
[*] http://mi-al.ru:80/crossdomain.xml => 301
[*] http://mi-al.ru:80/phpinfo.php => 301
[*] http://mi-al.ru:80/test.php => 301
[*] http://mi-al.ru:80/elmah.axd => 301
[*] http://mi-al.ru:80/server-status => 301
[*] http://mi-al.ru:80/jmx-console/ => 404
[*] http://mi-al.ru:80/admin-console/ => 404
[*] http://mi-al.ru:80/web-console/ => 404
[*] 1 interesting files found.

Поиск юзернейма на сайтах
use profiler
set SOURCE username
run

show profiles

Алсо

Другие OSINT утилиты


Ссылки


***
***
searx - метапоисковик.

пятница, 28 июля 2017 г.

Атака на WPA2 с использованием поддельной точки доступа


Механизм четырёхэтапного рукопожатия организован таким образом, что точка доступа (ТД) не обладая паролем может получить всё необходимое, для его подбора.

Атакующему необходимо создать точку доступа с ESSID (именем сети), совпадающим с именем сети, от которой требуется выяснить пароль и такими же настройками безопасности. Здесь рассматриватеся только WPA2 сети.
Устройство жертвы обнаружив сеть в эфире попытается к ней подключиться, отправив MIC (Message Integrity Code) содержимое которого и будет использована для перебора. Таким образом для атаки на пароль будет необходимо перехватить только первые два этапа 4-way handshake.
Боле подробно процесс подключения клиента к сети описан в этой статье.
В конце концов, так как поддельной ТД пароль неизвестен, клиент не сможет подключится.

Этот способ хорошо подходит, когда перехватить хэндшейк находясь рядом с ТД проблематично. Но нужно находится в зоне видимости устроства, которое автоматически подключается к интересующей сети.
После попытки подключения на клиентском устройстве может появится запрос на новый пароль.

Если не стоит задачи атаковать конкретную сеть, можно предположить названия сети самостоятельно и ждать подключения. Другой вариант - перехватить probe request кадры, которые рассылают устройства в поисках знакомых сетей поблизости.

Для атаки (создания поддельной ТД) будем пользоваться утилитой из aircrack-ng под названием airbase-ng. Документация приведена по ссылке.

1. Создадим поддельную точку доступа


airbase-ng -c 9 -e teddy -Z 4 -W 1 wlan0mon

-c 9 - канал
-e - ESSID
-Z 4 - определяет тип защиты, здесь - WPA2
-W 1 - установить флаг WEP. Некоторые клинеты не подключаются без него.
wlan0mon - интерфейс, на базе которого создаётся ТД.

Атака на несколько ESSID одновременно.
airbase-ng может перехватывать beacon frames, содержащие ESSID, и автоматически рассылать маячковые кадры c этим именем сети. Таким образом, точка доступа будет менять имя в сети, в зависимости от того, какие сети известны устройствам поблизости.

Добавим два параметра
-P - для мимикрии под актуальные сети;
-С 60 - число секунд, в течении которого точка доступа рассылает маячковые запросы с одним именем сети
и уберём ключ с именем сети.

airbase-ng -P -C 60 -c 9 -Z 4 -W 1 wlan0mon

2. Перехватить handshake.
Для этого можно использовать airbase добавив ключи:
airbase-ng ... -F dump -i wlan1mon
-F dump - имя файла для записи пакетов
-i wlan1mon - имя интерфейса, с которого будут записываться пакеты.

Интерфейс для записи лучше использовать отличный о того, что используется для работы в качестве ТД. Иначе может не получится записать пакеты клинта, содержащие MIC.

Другой вариант получения handshake - использовать airodump-ng также как и для атаки вблизи ТД:

airodump-ng -w dump -с 9 wlan1mon
Cледует проследить, что были перехвачены первые два этапа рукопожатия периодически натравливая aircarck на файл дампа или просматривая его содержимое вручную, например с помощью tshark:


3. Подбор пароля
Этот этап не отличается от аналогичного, где handshake получен при подключении клиента к настойщей ТД. Подробнее здесь.
aircrack-ng dump-01.cap -w wordlist

***

Похоже перехваченный handshake не всегда пригоден для брута [link]. Почему так происходит?

Алсо

airbase позволяет организовать и другие атаки, прочитать о которых можно в документации.

Организовать первые два этапа атаки можно и средствами мощного python-пакета Scapy.

Ссылки

airbase documentation
habrahabr: Wi-Fi сети: проникновение и защита.
How to get a WPA\WPA2 keys 4-way handshake using Airbase-ng

воскресенье, 28 мая 2017 г.

Обработка статистических данных в R

Для изучения и экспериментов лучше подходит интерактивный режим. Поэтому будем использовать именно его.

На примере этих (и других) данных будет рассмотрены возможности языка:
X =   "181.1 167.9 170.5 194.1 171.6 168.6 180.7 184.9 165.3 165.5 171.1 174.4 175.2 180.3 181.2 168.9 176.2 167.4 165.9 177.2 180.8 173.9 163.5 175.0 171.0 177.6 173.6 185.8 184.0 178.7 174.3 170.3 178.6 172.3 162.3 166.3 160.4 163.0 174.7 183.1"

Y =  "163.3 172.6 154.3 159.8 174.0 159.0 180.1 168.9 177.0 166.4 162.7 169.3 170.3 161.8 171.9 177.3 166.8 175.5 175.1 174.8 161.0 169.8 177.9 174.3 168.7 176.6 156.3 179.3 178.3 168.7 178.5 151.0 164.0 159.5 180.9 178.7 166.0 169.5 167.0 150.4"
Данные представлены не столбцом, а строкой. Поэтому для начала разобъём её на подстроки, а потом преобразуем в вещественные числа:
X = as.double(strsplit(X,' ')[[1]])
Работа с файловой системой
list.files() # список файлов
getwd()      # полное имя текущего каталога
setwd(dir)   # изменить каталог

Загрузка данных

Текстовые файлы. Загрузить текстовый файл как список строк
x <- scan("data.txt", what="", sep="\n")
CSV файлы.
D = read.delim('stud­lab.csv',';', header=TRUE)
';' - разделитель полей;
header - есть ли заголовок.

Пример файла
N;X;Y
0;15.04;12.0
1;16.24;14.18
2;7.96;12.12
3;17.4;7.98
XLS файлы. Для загрузки из xls файла потребуется пакет gdata (см. установку пакетов) [so]
require(gdata) # подключим пакет
read.xls("file.xls")

Работа с данными

сводка по данным
summary(D)

 N               X               Y       
 Min.   : 0.00   Min.   : 6.26   Min.   : 3.74 
 1st Qu.:24.75   1st Qu.:10.54   1st Qu.: 9.33 
 Median :49.50   Median :12.27   Median :11.14 
 Mean   :49.50   Mean   :12.34   Mean   :10.91 
 3rd Qu.:74.25   3rd Qu.:14.12   3rd Qu.:12.55 
 Max.   :99.00   Max.   :20.65   Max.   :17.94 

Работа с DataFrame
names(D) - имена полей

nrow(D), ncol(D) - число строк, столбцов

Доступ к полям. Имя поля (столбца) записывается после знака $:
D$X
Доступ к даныым можно получить используя индексацию: строка, столбец. 
D[42,] - 42 строчка таблицы
D[,2] - данные из второго столбца

Указывать набор конкретных строк\столбцов можно вектором:
D[ c(1,3,7, 13), ]
исключить эти столбцы:
D[ , - c(1,2) ]
Вместо индексов столбцов можно указывать их имена (тут унарный минус не работает):
mtcars[ , c('wt', 'am')]

Создание нового поля (заполненного нулями)
D$Z = 0  
Загрузка из Интернета.
...

Среда
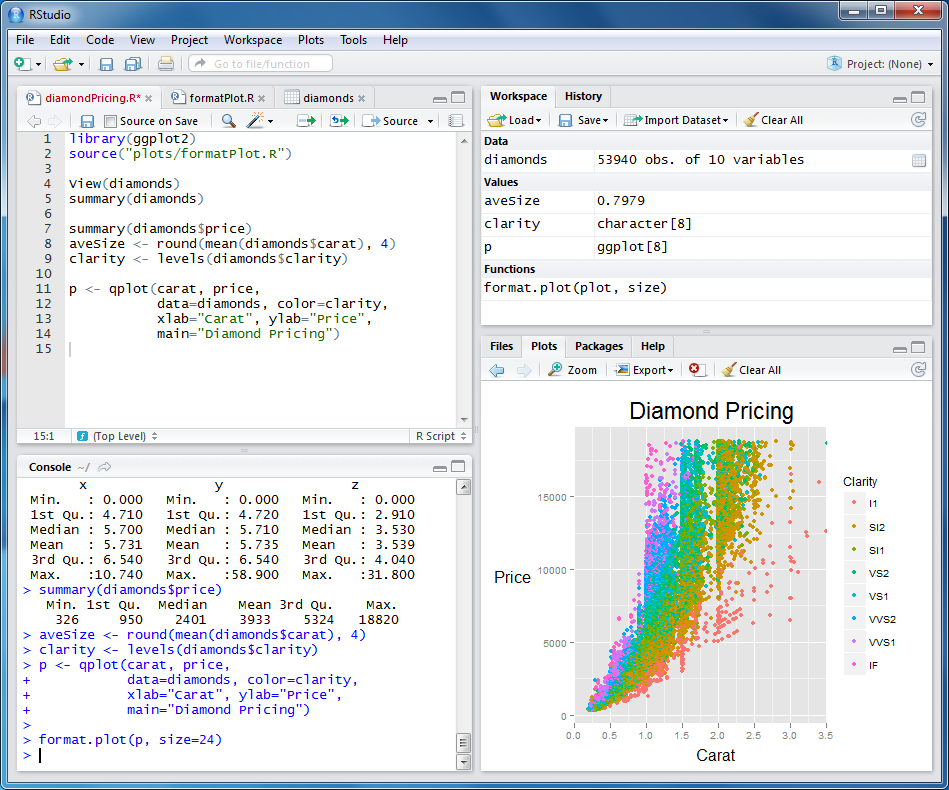
Самая популярная среда - R Studio.

Числовые характеристики


интервальные оценки

Графики

Диаграмма рассеивания
plot(D$X,D$X)
Дополнительные параметры функции plot:
xlab = "Ось X", ylab = "Ось Y" - подписи к осям;
col = "red" - цвет маркеров;
type = "b" - тип графика (p - точки (по умолчанию), l - линии, b - линии и точки, и т.п. см. справку по plot);
main = "Заголовок" - подпись сверху;
sub = "Подзаголовок" - подпись снизу.

Добавим координатную сетку:

grid()
Дополнительные параметры функции: nx=10,ny=10 - число делений сетки.

ggplot2
Более эстетичные графики можно построить с помощью библиотеки ggplot2
library(ggplot2)
ggplot(D, aes(x=D$X, y=D$Y))+geom_point() + xlab('X')+ylab('Y')

aes(x=D$X, y=D$Y) - задаёт соответствие осей данным
geom_point() - определяет способ отображения данных

Закрасить область
https://www.r-bloggers.com/creating-shaded-areas-in-r/

Сохранить график в файл
png('my-boxplot.png')
... Построение графика ...
dev.off()

Гистограмма

Диаграмма рассеивания

Ящик с усами или диаграмма размаха. 

boxplot(x,y)
Дополнительно стоит подписать каждую диаграмму, пусть это будут лаконичные имена случайных величин для которых они построены: X и Y. 
boxplot(x,y, names = c('X', 'Y') )
Дополнительные элементы графиков, такие как заголовок, подписи к осям и т.п. выполняются также как и для других графиков.

Проверка гипотез [wiki]

Для понимая нижеследующих процедур необходимы знания о процедурах проверки статистических гипотез, p-value (и ещё о p-value), уровне значимости и т.д.
Далее будем использовать уровень значимости α=0.05. Это самое часто используемое значение, хотя вопрос о его выборе заслуживает отдельной статьи. Для каждой проверки должны быть сформированы нулевая и альтернативные гипотезы. Часто, для краткости приводят только одну, например альтернативную: математические ожидания не равны. В таком случае оставшаяся гипотеза, например основная пряма противоположна первой: математические ожидания равны.

Проверка статистического распределения на нормальность

Требование "нормальности" часто встречается при проверке других статистических гипотез (например на равенство средних или дисперсий). Кроме того, знание о распределении может быть интересно само по себе. Или если нужно по статистическим данным получить гладкую кривую подобрав его параметры.
Используем одну из наиболее популярных в таких случаев проверок: критерий Шапиро-Уилка. 
Нулевая гипотеза: случайная величина распределена нормально.
Альтернативная гипотеза: случайная величина не распределена нормально.
shapiro.test(x)
Результат:
    Shapiro-Wilk normality test

data:  x
W = 0.98343, p-value = 0.2434
 Здесь мы видим два числа, W - значение критерия и p-value. Они могут использоваться независимо при проверке гипотез. 
В этом примере, p-value > α, значит принимаем нулевую гипотезу: с.в. распределена нормально.

о равенстве дисперсий

...

Гипотеза о равенстве математических ожиданий

Предположим, что по данным выборки, где известны средние требуется установить, равны ли математические ожидания в генеральных совокупностях, откуда были сделаны эти выборки. Непосредственным сравнение выборочных средних этого сделать нельзя, потому, что эти средние, например, могут отличатся. Так как сравниваются выборки, то вполне вероятно, что различия в средних получились совершенно случайно. В большинстве остальных выборок эти средние равны. Поэтому возникает вопрос: насколько можно доверять различию выборочных средних средних?
Лучше всего для этого построить доверительные интервалы для генеральных математических ожиданий.
Если изучаются различия в нормально распределенных выборках, где медиана и математическое ожидание равные, то эти различия можно оценить построив диаграмму размаха:
boxplot(x,y, names = c('X', 'Y') )
Например для выборок A и B (пусть они содержат по 100 элементов) проверку средних производить не имеет смысла. Большинство, около 3/4, значений каждой выборки расположены в разных областях числовой прямой. Выборки различны, а значит и средние значения различны.
Для следующих выборок (см. данные в начале), ответ на вопрос о равенстве средних уже не так очевиден:
Стоит помнить, что на диаграмме приводятся медианы (жирная линия) а не средние. Поэтому вычислим последние отдельно:
> mean(X); mean(Y)
[1] 173.9
[1] 168.9
Да, разница есть. Но на сколько она существенна, с учётом дисперсий и объёмов выборок?

Далее следует определится с выбором критерия (pdf), который будет применятся для сравнения. Для этого может понадобится проверить выборки на соответствие требованиям критерия.
Рассмотрим два теста (см. pdf выше): Z-тест и T-тест.
Предположим, что выборки сделаны из нормально распределенных генеральных совокупностей. То есть подходят под одноименное требование Z-теста. Однако дисперсии генеральных совокупностей неизвестны. Казалось бы, что эти величины можно заменить одноименными но для выборок, но в результате увеличится элемент случайности, который тоже нужно будет учесть. Как раз для этой задачи существует T-тест, поэтому остановим свой выбор на нём.

Нулевая гипотеза H0: M(X) = M(Y), математические ожидания генеральных совокупностей равны.
> t.test(X,Y)
    Welch Two Sample t-test

data:  X and Y
t = 2.8408, df = 77.187, p-value = 0.005753
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 1.494589 8.500411
sample estimates:
mean of x mean of y
 173.9300  168.9325 
p-value < α, значит отклоняем нулевую гипотезу. Математические ожидания генеральных совокупностей не равны.

Установка пакетов [r-bloggers]
install.packages("ggplot2")

Ссылки

stepic.org

пятница, 12 мая 2017 г.

Математика в Python

Некоторые библиотеки python используемые в научных вычислениях, визуализации и обработке данных:
  • numpy - работа с матрицами и многомерными массивами
  • scipy - научные и инженерные вычисления, использует numpy;
  • matplotlib - построение графиков и диаграмм;
  • seaborn - визуализация статистических данных, эстетичнее чем matplotlib; 
  • mpld3 - использование D3.js для построения интерактивных matplotlib графиков в окне браузера;
  • pandas - анализ данных: статистики, регрессия, визуализация и т.п.

Для вычислений на лету, экспериментов и вообще работы с научными данными рекомендуется использовать Jupiter Notebook - интерпретатор Python (и не только) прямо в браузере. Интерфейс похож на оный математических пакетов. Попробовать прямо сейчас.

Линейная алгебра

import numpy as np 

Создание матрицы

A = np.array([ [1,2,3],
               [3,2,1],
               [2,1,3] ] ) 
Данная матрица это двумерный массив (список), только в обёртке numpy.

Операции.

Умножение на скаляр
A * 3.14
> array([[ 3.14,  6.28,  9.42],
         [ 9.42,  6.28,  3.14],
         [ 6.28,  3.14,  9.42]])
 
Умножение на вектор
A * [2,3,4]
Причём здесь вектор не обязательно должен быть типом numpy.

Сложение матриц 
A+B

Умножение матриц
A @ B
или
np.dot(A,B)

Обратная матрица
np.linalg.inv(A)

Решение СЛАУ
import numpy
numpy.set_printoptions(precision=4, suppress=True)
A = numpy.matrix([
    [1, 1, 3],
    [1, 2, 2],
    [1, 3, 1]])
B = numpy.matrix([[1], [2], [3]])
X = numpy.matrix([[0], [0], [0]])
X = numpy.linalg.solve(A, B)
 
Стоит обратить внимание на то, что вектор-столбец определяется как матрица из одного столбца, а не как список.

Интерполяция

from scipy.interpolate import interp1d
 
X = [1,2,3,4,5,6,7]
Y = [1,4,9,16,25,36,49]
func = interp1d(X, Y, kind='cubic')
func(5.3)
 
>>> array(28.090000000000003)
 
 
Минимизация функции
from scipy.optimize import minimize
def funcXX(x): 
   return (x-3)*(x-3) - 5
x0 = 100 # начальное значение
minimize(funcXX, x0)
 
Вывод:
nfev: 12
jac: array([ 0.])
message: 'Optimization terminated successfully.'
fun: -5.0
success: True
x: array([ 3.])
njev: 4
hess_inv: array([[ 0.5]])
status: 0
Минимум функции: f(3) = -5


Для функции с дополнительными (не оптимизируемыми) параметрами:
def funcXX(x, c1=0, c2=0, c3=0): 
   return (x-c1)*(x-c2) - c3
x0 = 100
minimize(funcXX,100, args=(3,3,5))

Оптимизация по нескольким параметрам (по списку):
def funcXX(x): 
    return ( 1 - x[0] )**2 + 100 * ( x[1] - x[0]**2 )**2
X0 = [10,10]
minimize(funcXX, X0)

Вывод:
     nfev: 292
      jac: array([  1.38046018e-06,  -6.34189745e-07])
  message: 'Optimization terminated successfully.'
      fun: 1.956291539083183e-11
  success: True
        x: array([ 0.99999558,  0.99999115])
     njev: 73
 hess_inv: array([[ 0.50636053,  1.01234176],
       [ 1.01234176,  2.02894044]])
   status: 0
Параметром method указывается конкретный метод оптимизации из числа возможных:
'Nelder-Mead', 'Powell', 'CG', 'BFGS', 'Newton-CG', 'Anneal', 'L-BFGS-B', 'TNC',  'COBYLA',  'SLSQP', 'dogleg', 'trust-ncg'. По-умолчанию применяется BFGS.

Чиленное интегрирование и дифферецирование [Integration (scipy.integrate)]

from scipy.integrate import quad 
# интеграл от sin(x) в пределах от 0 до pi/2
quad(lambda x: sin(x): 0, pi/2) 
>>> (0.9999999999999999, 1.1102230246251564e-14)

Результат выполнения функции - кортеж, первый элемент которого - значение интеграла.

Значение производной в точке 2 (dx=1e-6 - шаг для вычисления производной численным методом):
from scipy.misc import derivative 
derivative(lambda t: -3/(t+2), 2, dx=1e-6) 
 
0.18750000002620837

График функции [подробнее, ещё ] 
Чтобы  

Путём задания функции:
from pylab import *
t = arange(0.0, 2.0, 0.01)
s = sin(2*pi*t)
plot(t, s)
xlabel('time (s)')
ylabel('voltage (mV)')
# добавить горизонтальную штриховую линию красного цвета
plt.axhline(y=-sh.S,ls ="dashed",color="red")
# можно указать размер шрифта в заголовке
title('About as simple as it gets, folks', fontsize=16)
grid(True)
savefig("test.png")
show()

График по точкам:
import matplotlib.pyplot as plt
plt.plot([1, 2, 3, 4], [1, 4, 9, 16], 'ro-', linewidth=2.0)
# включить легенду и подобрать для неё оптимальное пложение
pl.legend(loc='best')
plt.show()
 
'ro-' - красные круглые маркеры, соединенные сплошной линией
***
Закрасить область между прямой y = 0.9 и кривой y = Ffunc(); между абсциссами x1 и x2.
fill_between(np.linspace(x1,x2,100), 0.9, Ffunc(np.linspace(x1,x2,100)), color = 'yellow', alpha=0.3)
 
Кривая представляется массивом значений y. Интервал абсцисс задаётся массивом той же размерности.

***
Добавить подпись (греческие и проч. символы) в LaTeX нотации:
plt.ylabel("$\\sigma_r$ [MPa]")

***
Нарисовать наклонные подписи под осью [SO]
plt.xticks(rotation=30)

***
Text rendering With LaTeX
http://matplotlib.org/users/mathtext.html


dx, dy = 0.25, 0.25
# generate 2 2d grids for the x & y bounds
y, x = np.mgrid[slice(-30, 30 + dy, dy), slice(-30, 30 + dx, dx)]
z = (1 - x / 2. + x ** 5 + y ** 3) * np.exp(-x ** 2 - y ** 2)
z = z[:-1, :-1]
z_min, z_max = -np.abs(z).max(), np.abs(z).max()
plt.clf()
plt.pcolor(x, y, z, cmap=cm.gray, vmin=z_min, vmax=z_max)
plt.title('F(u0,ssr0)')
# set the limits of the plot to the limits of the data
plt.axis([x.min(), x.max(), y.min(), y.max()])
plt.colorbar()
plt.show() 


Теплокарта на основе набора значений X,Y [SO]
Чем больше раз встречается то или иное значение тем "горячее" будет точка.
import numpy as np
import numpy.random
import matplotlib.pyplot as plt
 
# Generate some test data
x = np.random.randn(8873)
y = np.random.randn(8873)
 
heatmap, xedges, yedges = np.histogram2d(x, y, bins=(512, 512))
extent = [xedges[0], xedges[-1], yedges[0], yedges[-1]]
 
plt.clf()
plt.imshow(heatmap, extent=extent)
plt.show()


***
Сделать картинки красивыми поможет пакет seaborn. Эту надстройку над matplotlib можно использовать непосредственно. Однако, пакет удобен прежде всего для визуализации различных данных, а не исключительно математических графиков. Поэтому при необходимости используются только стиль, а остальные операции выполняются с помощью непосредственно matplotlib.
import seaborn as sb
sb.set_style("darkgrid")  # установить стиль seaborn
Методом set можно изменить другие параметры рисования, например ращмер шрифта
sb.set(font_scale=1.55)

***

Создавать одновременно красивые и интерактивные диаграммы и графики можно с помощью пакета plotly. Удобнее всего работать с этим пакетом, если оболочка Питона запущена прямо в браузере ибо созданные диаграммы представляют собой автоматически сгенерированные html страницы с включением кода на JS. 

Графы

Библиотеки: NetworkX,

Работа с массивами данных

Сохранить массивы в cvs файл
import numpy
a = numpy.asarray([ [1,2,3], [4,5,6], [7,8,9] ])
numpy.savetxt("foo.csv",  numpy.transpose(a), delimiter=" ", fmt="%1.4f", header = "val1, val2, val3")
foo.cvs:
# val1, val2, val3
1.0000 4.0000 7.0000
2.0000 5.0000 8.0000
3.0000 6.0000 9.0000
Загрузка данных из cvs файла.
numpy.genfromtxt
from numpy import genfromtxt
my_data = genfromtxt('my_file.csv', delimiter=',', unpack=True).transpose()
Функция genfromtxt возвращет данные как они записаны в вайле (см. выше). Чтобы получить вместо списка данных по строками (одна строка - один массив), список данных по столбцам, нужно перевернуть (.transpose()) или передать в функцию параметр unpack=True.
>>> my data
 
array([[ 1.,  2.,  3.],
           [ 4.,  5.,  6.],
           [ 7.,  8.,  9.]])
При необходимости можно сразу записать данных в отдельные массивы. Их число должно совпадать с числом полей.
v1, v2, v3 = genfromtxt('data/test2', unpack=True) 
Функция numpy.genfromtxt выполняет ту же работу, но с дополнительными возможностами вроде автоматического заполнения пустых полей.

Алсо

Pandas - анализ данных

Ссылки